Wie ich mit KI in einer Sitzung einen MP3-Downloader gebaut habe
Veröffentlicht am 17. Oktober 2026 · Kategorie: KI, Projekt, Python, Tools, Open Source
Manchmal braucht man keinen Projektplan, kein Lastenheft und keine Zeile Code – man beschreibt einfach in normalem Deutsch, was man haben will. Genau so ist mein MP3-Downloader entstanden: gesagt, recherchiert, gebaut. Keine IDE, kein langes Suchen, keine Dokumentation gewälzt. Hier die ganze Geschichte – und wie verblüffend einfach KI-Programmierung heute ist.
Die Idee: einfach gesagt, nicht programmiert
Der Auftrag an meinen lokalen Assistenten war ein einziger Satz:
„Erstelle einen MP3-Downloader. Suche im Internet nach allen möglichen Quellen – wenn der Nutzer ein Lied oder einen Interpreten eingibt, soll es immer gefunden werden, ggf. über YouTube oder alle möglichen legalen Quellen. Die Musik soll dann immer als MP3 gespeichert werden, ggf. konvertieren."
Mehr nicht. Danach hat die KI selbst nachgedacht: Welche Quellen gibt es? Welche funktionieren ohne Login? Welche sind legal? Sie hat die APIs getestet, sich für Openverse, Internet Archive, Wikimedia Commons und YouTube (via yt-dlp) entschieden und anschließend die komplette App geschrieben – GUI, Download-Logik, MP3-Konvertierung, Tags, Doku und Starter.
Schön nebenbei: Meine erste Idee war eigentlich, Spotify-Lieder herunterzuladen. Die KI hat das abgelehnt – das wäre DRM-Umgehung und rechtlich nicht sauber – und stattdessen die legale Variante vorgeschlagen. So habe ich es gern.
Das Ergebnis: eine echte Windows-GUI-App
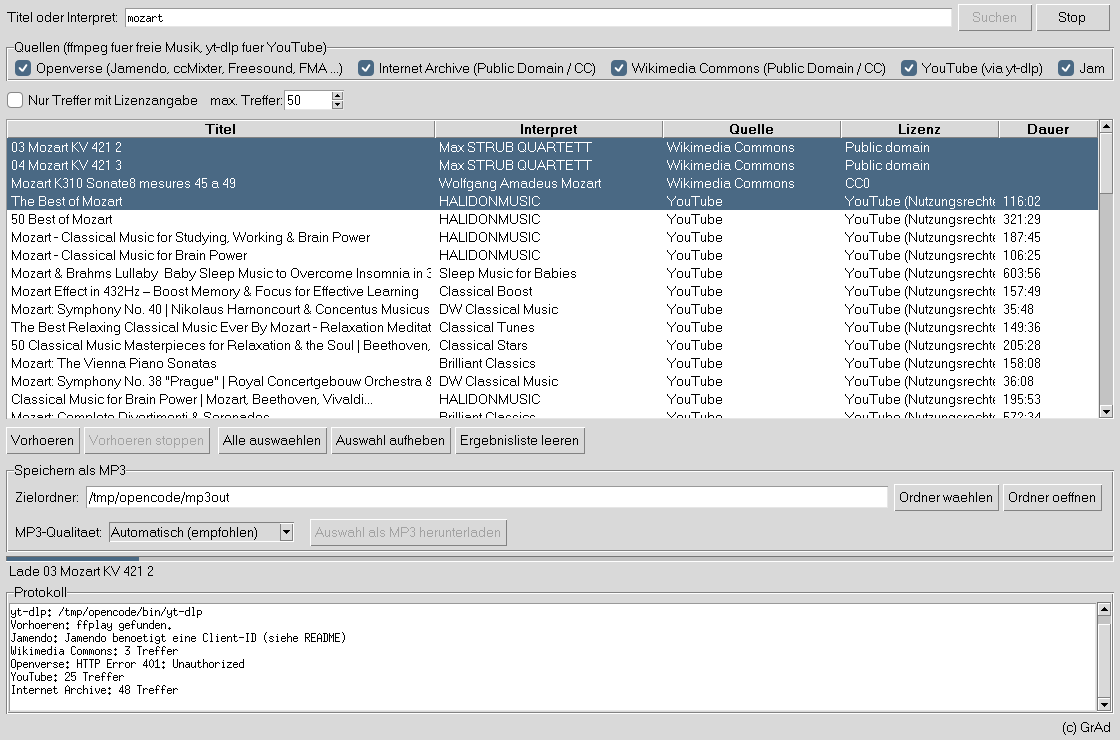
Die fertige App: Titel oder Interpret eingeben, Quellen wählen, Treffer bekommen – 76 Treffer allein für „mozart".
Was die App alles kann:
Mehrere Suchquellen: Openverse (Jamendo, ccMixter, Freesound, FMA …), Internet Archive, Wikimedia Commons und optional Jamendo mit eigener Client-ID
YouTube über yt-dlp: Suche und Audio-Download, automatisch in MP3 gewandelt
Immer MP3:ffmpeg konvertiert alle Formate (OGG, FLAC, WAV, M4A …) – echte MP3-Quellen werden verlustfrei kopiert
ID3-Tags & Attribution: Titel, Interpret und Quelle/Lizenz werden eingetragen, zusätzlich entsteht eine ATTRIBUTION.txt
Vorhoeren: kurzes Antesten per Doppelklick – mit ffplay oder, falls das fehlt, über einen ffmpeg-WAV-Fallback
Alles gebündelt:ffmpeg und yt-dlp liegen im bin/-Ordner – keine Installation, kein PATH-Gefummel
Komfort: Zielordner wählbar, MP3-Qualität, „Alle auswählen", Fortschrittsbalken und ein Protokoll, das jeden Schritt zeigt
Im Einsatz: mehrere Treffer markiert und der Batch-Download läuft – die App wandelt jeden Treffer sauber in eine MP3 um.
Wie einfach war das? Sehr.
Der ganze Ablauf war ein Gespräch, kein Programmier-Marathon:
Wunsch in einem Satz – die KI recherchiert passende Quellen und prüft sie direkt (echte Testabfragen).
Code entsteht von selbst – GUI, Downloader, ffmpeg-Anbindung, Tags, alles in einem Rutsch geschrieben und kompiliert.
Korrekturen per Zuruf. „ffplay fehlt → Vorhören geht nicht" → die KI baut einen ffmpeg-Fallback und liefert ffmpeg gleich mit. „Kannst du YouTube auch einbauen?" → yt-dlp wird integriert. „Füge unten rechts (c) GrAd hinzu" → erledigt.
Getestet, nicht behauptet – die KI hat echte Downloads ausgeführt und die entstandenen MP3s (ID3-Header, ATTRIBUTION.txt) validiert.
Unterm Strich: Ich habe keine einzige Zeile selbst geschrieben, keine Bibliothek nachgeschlagen und nichts installiert. Beschreiben, prüfen, fertig – das ist der ganze Trick.
Die ehrlichen Haken
Damit hier kein falscher Eindruck entsteht – es gibt ein paar Punkte, die man kennen sollte:
Rechtliches: Die App durchsucht bewusst freie Lizenzen und Public Domain. Der YouTube-Weg über yt-dlp ist ein Zusatz für Inhalte, die man herunterladen darf (eigene Uploads, CC-/gemeinfreies, Erlaubnis) – das steht so auch in der README.
Ein Abbruch mitten in der Arbeit: Während des Bauens lief ein API-Schlüssel ab (HTTP 401) – die Sitzung brach ab, wurde aber nahtlos fortgesetzt und fertiggestellt.
Rate-Limits: Openverse erlaubt anonym nur wenige Anfragen pro Minute; kommt mal ein Fehler, fängt die App ihn mit einem automatischen Retry ab und nutzt die anderen Quellen.
Fazit
Ein vollwertiges Stück Software – Windows-GUI, Netzwerk, Audio-Konvertierung, Tags, Doku – entstanden aus einem gesprochenen Satz und ein paar lockeren Nachfragen. Genau das ist der Reiz von KI als Werkzeug: Sie nimmt einem das Textbaustein-Gefummel ab, während man sich auf die Idee konzentriert. Wer Lust hat, kann die App direkt ausprobieren.
MP3-Downloader herunterladen
Im Paket stecken die komplette App (mp3_downloader.py), der Windows-Starter, die README sowie ffmpeg und yt-dlp inklusive. Entpacken, start_mp3_downloader.bat doppelklicken – läuft. Es ist nichts weiter zu installieren.
Mein JARVIS-Projekt: Ein komplett lokaler Sprachassistent im Iron-Man-Stil
Veröffentlicht am 16. Oktober 2026 · Kategorie: KI, Projekt, Lokale KI, Sprachassistent, Open Source
„J.A.R.V.I.S. – Just A Rather Very Intelligent System." In den Iron-Man-Filmen ist er Tonys rechte Hand: Stimme, Gedächtnis und Kontrollzentrum in einem. Ich habe mir meinen eigenen gebaut – und zwar komplett lokal. Kein Cloud-Dienst, kein Token-Abo, keine Daten, die das Haus verlassen. Was dabei alles passiert ist, welche Modell-Odyssee dahinter steckt und wie du ihn selbst installierst, steht hier.
Was ist JARVIS?
JARVIS ist ein Sprachassistent, der auf dem eigenen Rechner läuft und sich wie im Film anfühlt:
Sprechen → aufgenommen über ffmpeg/PulseAudio
Verstehen → Whisper (Speech-to-Text, lokal, GPU oder CPU)
Denken → ein lokales LLM über Ollama, angesteuert über den OpenCode-Agenten (mit Tools für Mail, Kalender, PC-Steuerung, Internet)
Antworten → Piper-TTS mit einer echten „J.A.R.V.I.S."-Stimme (deutsch und englisch)
Anzeigen → ein holografisches Web-HUD mit rotierendem Arc-Reactor
Der komplette Ablauf: Mikro → Whisper → OpenCode → Modell → Piper. Alles auf deiner Hardware, alles offline möglich.
Der Film-Look: das Web-HUD
Das Herzstück der Optik ist die Weboberfläche. Ein animierter Arc-Reactor mit rotierenden Ringen, Tick-Kranz, Partikeln und pulsierendem Kern, dazu Statusanzeige, Fortschrittsbalken (Audio-Analyse links, Token-Engine rechts) und stilvolle Untertitel im Wechsel DU / J.A.R.V.I.S. / SYSTEM. Der Look ist bewusst an das Filmlabor angelehnt – dunkles Blau, Neon-Cyan, holografisches Leuchten.
Das Web-HUD: Arc-Reactor, Statusleiste, Untertitel und Sprach-Dock – komplett in HTML/Canvas, lokal ausgeliefert.
Bedient wird das Ganze unten über das Dock: Textbefehl eintippen oder den „Sprechen"-Button (bzw. die Leertaste) drücken. Die Untertitel bleiben stehen, solange Jarvis zuhört, denkt oder spricht – und verschwinden erst etwa 20 Sekunden nach Ende der Sprachausgabe, damit der Bildschirm wieder frei wird.
Alles einstellbar – direkt im HUD
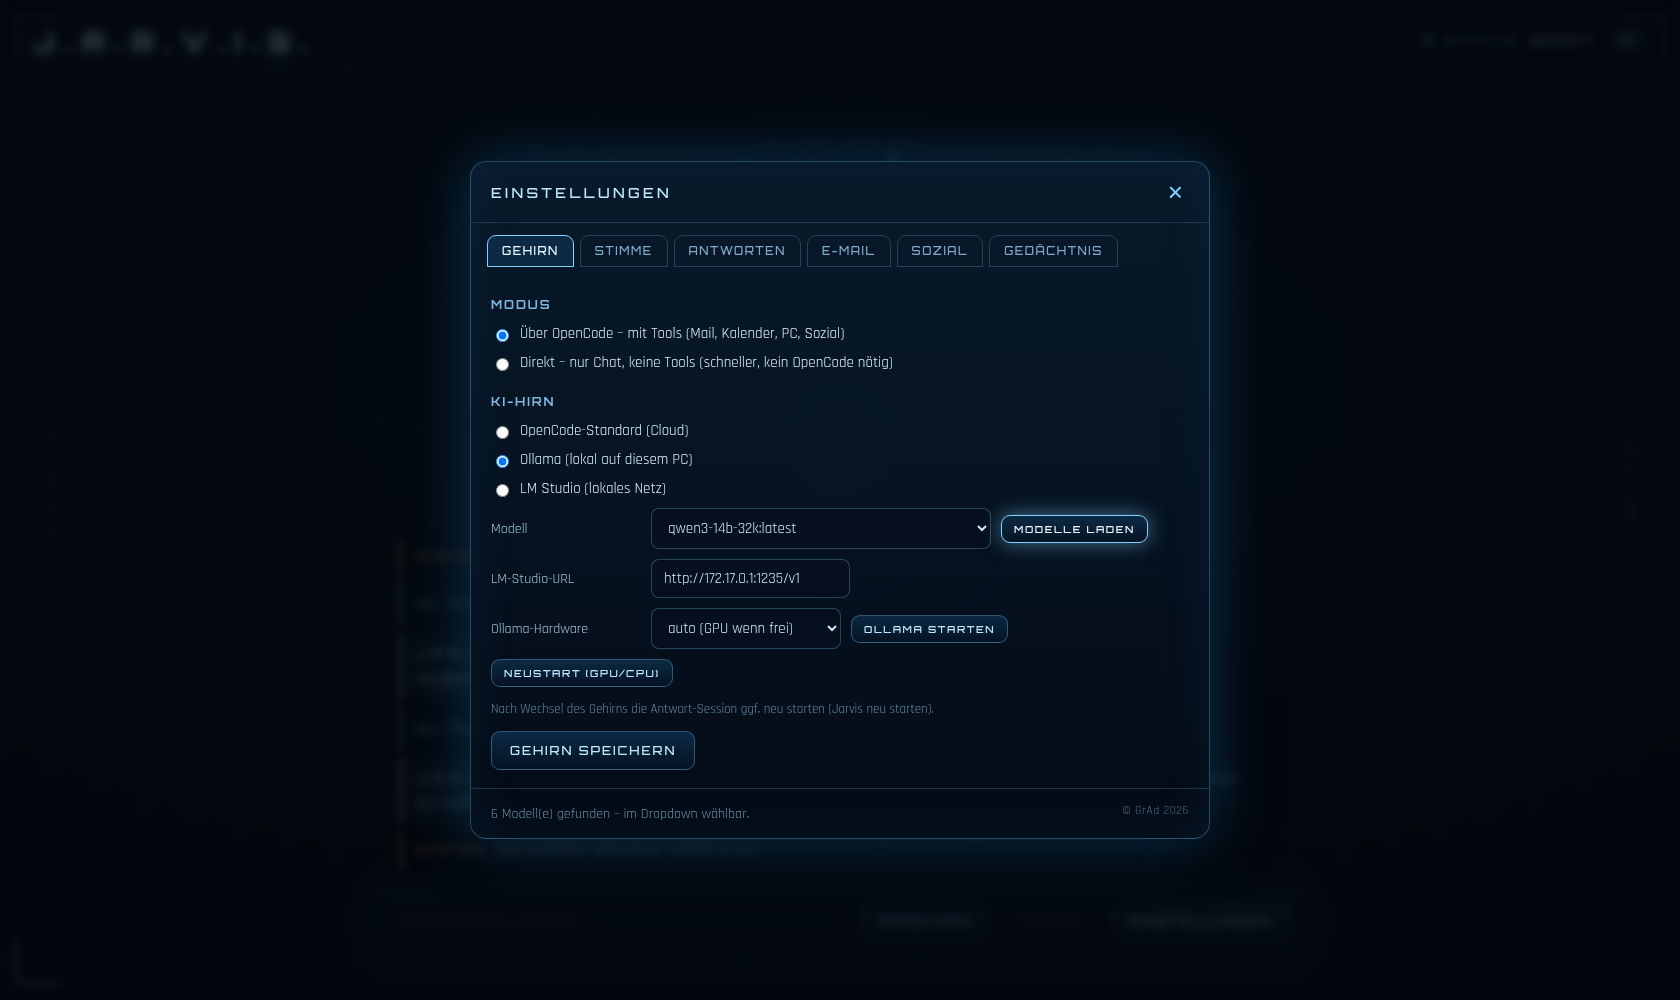
Statt Konfigurationsdateien zu editieren, hat das HUD einen kompletten Einstellungs-Dialog mit sechs Tabs bekommen:
Gehirn – Modus (über OpenCode mit Tools oder direkt ohne Tools), KI-Backend (Cloud / Ollama / LM Studio) und Modellwahl mit „Modelle laden"
Stimme – alle Piper-Stimmen, inklusive lokaler Hörprobe zum Anhören
E-Mail – IMAP (Empfang) und SMTP (Versand) mit Verbindungstest
Sozial – Facebook, Instagram und TikTok über offizielle APIs
Gedächtnis – aus, nur Fakten oder Lernen aus Gesprächen (RAG)
Tab „Gehirn": Modus-Schalter, lokale Modelle auswählen – die Dropdown-Liste wird per Klick befüllt.
Tab „Stimme": Piper-Stimmen mit lokaler Hörprobe.Tab „Sozial": Facebook, Instagram & TikTok über offizielle APIs.
Tab „Gedächtnis": merkt sich nur explizite Fakten oder lernt aus Gesprächen – alles lokal in data/memory.json.
Die Arbeit dahinter – eine ehrliche Chronik
So ein Projekt entsteht nicht in einer Stunde. Hier die wichtigsten Etappen, die in den Sitzungen wirklich angefallen sind:
💥 Der Absturz und seine Ursache
Zuerst ist Jarvis unter WSL „eingefroren". Die Spur lag nicht im Code, sondern in Windows: Die Live-Kernel-Reports zeigten mehrfach Kernel_141 = VIDEO_ENGINE_TIMEOUT_DETECTED (TDR) – die GPU hatte sich aufgehängt, Windows hat den Treiber zurückgesetzt. Auslöser: Ein zu großes Ollama-Modell lief gleichzeitig mit dem Speech-to-Text auf der GPU. Lehre: Die Modellgröße muss in den VRAM passen, sonst gibt es GPU-Timeouts.
🪟 One-Click-Start unter Windows
Damit es kein Gebastel bleibt, gibt es jetzt start_jarvis.bat (und eine unsichtbare .vbs-Variante). Ein Doppelklick prüft und installiert bei Bedarf WSL + Ubuntu, alle Systempakete (ffmpeg, zstd, espeak-ng …), Ollama + Modelle, die Python-Umgebung, die Piper-Stimmen und startet danach das Web-HUD. Unter Linux reicht ./install.sh und ./run.sh.
🧠 Die Modell-Odyssee
Der spannendste Teil war die Suche nach dem „richtigen Gehirn". Kurzfassung der Stolpersteine:
Ein Gemma-Finetune verstrickte sich im Reasoning und brach ohne Text ab – „leere Antwort".
Ein „VibeForged"-Qwen-Finetune konnte Tools, verschrieb aber systematisch Pfade und redete Kauderwelsch.
qwen2.5-coder weigerte sich beharrlich, Ollama-konforme Tool-Calls zu senden → konnte keine Dateien anlegen.
Der Klassiker: ein Modell mit nur 4096 Token Kontext → Endlosschleife, weil OpenCode mehr Kontext schickt.
Die „Denk-Explosion": bis zu 27.000 Reasoning-Tokens und 72 s pro Schritt, ohne zu handeln.
Die Lösung: ein abgeleitetes Modell mit 32k-Kontext und abgeschaltetem Denken – final qwen3-14b-32k, das schnell, deutschstark und tool-fähig ist.
🛠️ Selbstständigkeit erzwingen
Anfangs hat der Assistent Aufgaben reflexartig an Unteragenten delegiert, den falschen Skill geladen und dann Erfolg behauptet, ohne etwas zu prüfen. Mit klaren Regeln im AGENTS.md („arbeite selbst", „keine Skills", „Werkzeuge benutzen statt beschreiben", „erst nach Prüfung als fertig melden") und dem Abschalten von Subagenten arbeitet Jarvis jetzt selbstständig und nachvollziehbar.
🌐 Internet im Direkt-Modus
Im schnellen Direkt-Modus (ohne OpenCode) hatte Jarvis zunächst kein Internet. Jetzt hat er eine eigene Suche: web_search (Bing, ohne API-Key), web_fetch und ein news-Tool für echte Schlagzeilen – inklusive Tool-Calling-Schleife und einer Sprachausgabe, die keine URLs mehr vorliest.
📱 Soziale Netze & Projekte
Neu sind außerdem die Integrationen für Facebook, Instagram und TikTok (ausschließlich über offizielle APIs mit Tokens, keine Passwörter) und ein Standard für neue Projekte: Sagt man Jarvis „bau mir ein Tool", legt er automatisch den Ordner projekte/<name>/ an und arbeitet nur dort.
Hardware: Was brauchst du?
Der Installer ist schlau: Er lädt immer das kleine phi4-mini und zusätzlich qwen3:14b, sobald mindestens ~11 GB VRAM vorhanden sind. So läuft JARVIS vom schwachen Laptop bis zur Workstation – du musst nichts von Hand auswählen.
🪶 Minimal – das kleinste Modell (CPU-only)
Modell:phi4-mini (3,8B), ~2,5 GB bei Q4-Quantisierung
RAM:4–8 GB – keine Grafikkarte nötig
Läuft sogar auf einem Raspberry Pi 5 (8 GB) oder einem älteren Laptop
Tempo: ca. 4–14 Token/s auf CPU – für Chat, Wetter, Notizen und kurze Fragen völlig ausreichend
Noch kleiner:llama3.2:3b (~2 GB) für absolute Minimum-Hardware
Auf so einer Maschine nutzt du für die Spracherkennung ein kleines Whisper-Modell (tiny/base) und die Antworten kommen spürbar langsamer – aber es funktioniert vollständig offline.
✅ Empfohlen – der Sweet Spot
GPU:16 GB VRAM (z. B. RTX 5060 Ti / 4060 Ti 16 GB) oder Apple Silicon mit 16 GB Unified Memory
Hier laufen Sprache (Whisper large-v3-turbo) und Modell gleichzeitig flüssig – Antwort in 1–3 s
🚀 Ideal – maximale Leistung
GPU: 24 GB VRAM (RTX 4090 / 3090) oder Mac Studio mit 32 GB+
Modell:deepseek-r1:32b (Reasoning) oder ein Qwen-Coder-30B
RAM: 32–64 GB
Für mehrere Modelle parallel, lange Kontexte und agentische Mehrschritt-Aufgaben
Übersicht
Klasse
Hardware
Modell
Minimal
4–8 GB RAM, CPU-only (auch Raspberry Pi 5)
phi4-mini (~2,5 GB)
Empfohlen
16 GB VRAM, 16–32 GB RAM
qwen3-14b-32k (~14 GB)
Ideal
24 GB+ VRAM, 32–64 GB RAM
deepseek-r1:32b / Qwen-Coder 30B
Faustregel: Bei Q4-Quantisierung brauchst du grob 0,6–0,7 GB Speicher pro Milliarde Parameter, plus Reserve für den Kontext. Wichtig: Das Modell muss in den VRAM passen – läuft es über, ruckelt es oder es kommt zum gefürchteten GPU-Timeout (TDR), genau wie in der Chronik oben beschrieben.
Warum lokal?
Datenschutz: Sprache, Mails und Dokumente bleiben auf dem Rechner.
Offline: Der Assistent funktioniert auch ohne Internet.
Keine laufenden Kosten: nach der Hardware nichts mehr pro Anfrage.
Kein Kill-Switch: Niemand kann von außen deine KI abschalten.
Volle Kontrolle: Modell, Stimme, Gedächtnis und Verhalten bestimmst du.
Fazit
JARVIS ist für mich der Beweis, dass lokale KI längst kein Kompromiss mehr ist: ein vollwertiger Sprachassistent mit Film-Feeling, echten Tools und null Cloud-Abhängigkeit. Es steckt viel Debugging in der Modell-Auswahl – aber genau das macht den Reiz aus. Und das Beste: Man kann ihn in wenigen Minuten selbst aufsetzen.
JARVIS herunterladen
Das komplette Paket enthält den Installer, das Web-HUD, die Skills (Mail, Kalender, PC-Steuerung, Social, Internet) sowie Start- und Deinstallations-Skripte. Der Installer richtet unter Windows automatisch WSL, Ollama, die Modelle, die Python-Umgebung und die Stimmen ein – unter Linux genügt ein Skript.
Ein Klick, ein Doppelstart – und J.A.R.V.I.S. übernimmt.